|
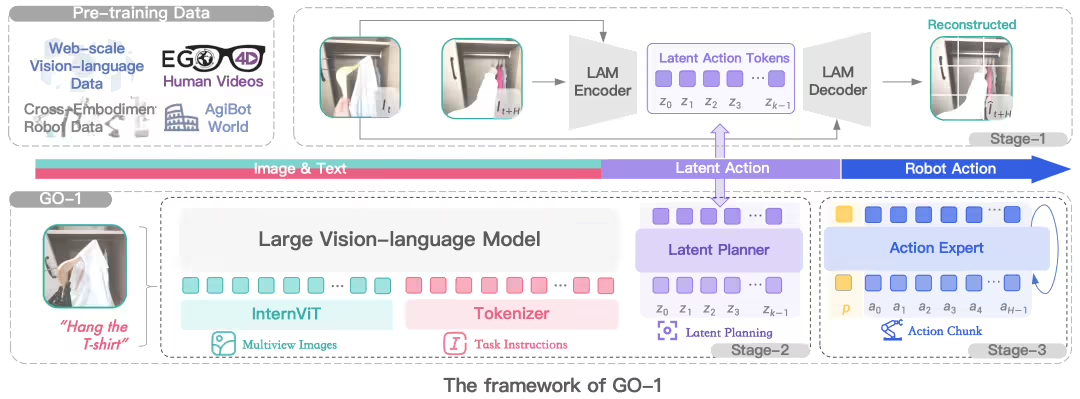
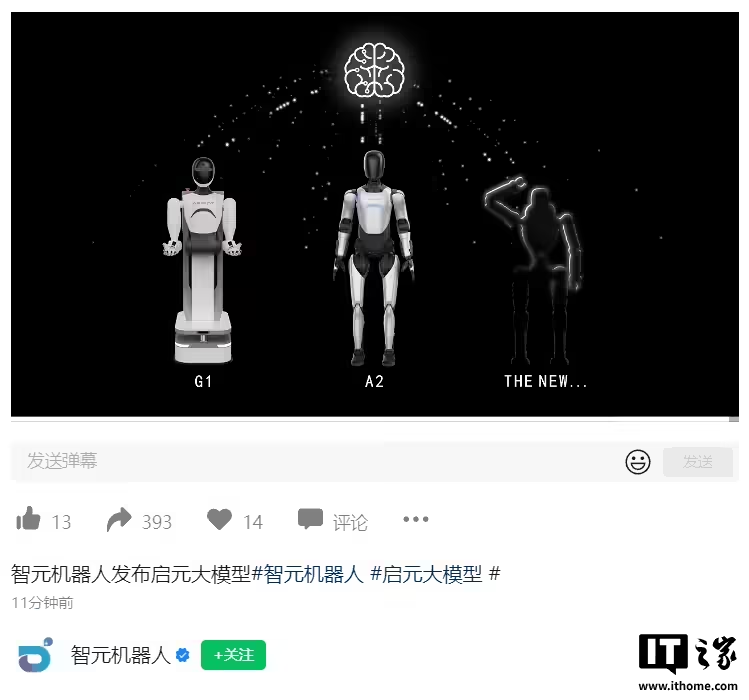
3 月 10 日消息,“稚晖君”创业项目智元机器人今日发布了首个通用具身基座模型 —— 智元启元大模型(Genie Operator-1),它开创性地提出了 Vision-Language-Latent-Action(ViLLA)架构,该架构由 VLM(多模态大模型)+ MoE(混合专家)组成,实现了可以利用人类视频学习,完成小样本快速泛化,降低了具身智能门槛,并成功部署到智元多款机器人本体。
2024 年底,智元推出了 AgiBot World,包含超过 100 万条轨迹、涵盖 217 个任务、涉及五大场景的大规模高质量真机数据集。基于 AgiBot World,智元今天正式发布智元通用具身基座大模型 Genie Operator-1(GO-1)。
它开创性地提出了 Vision-Language-Latent-Action(ViLLA)架构,该架构由 VLM(多模态大模型)+ MoE(混合专家)组成:
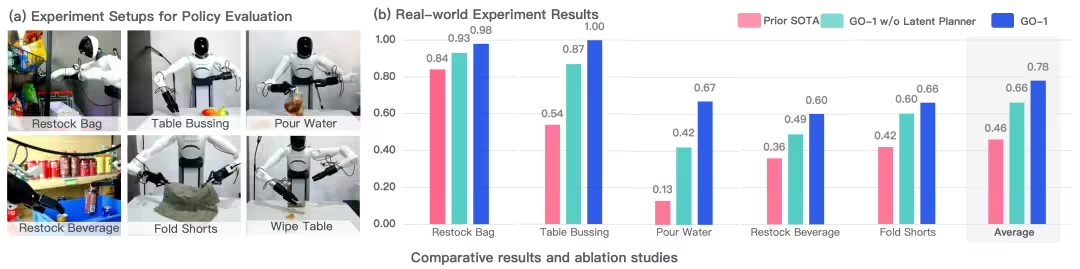
通过 ViLLA 架构,智元机器人在五种不同复杂度任务上测试 GO-1,相比已有的最优模型,GO-1 成功率大幅领先,平均成功率提高了 32%(46%->78%)。其中“Pour Water”(倒水)、“Table Bussing”(清理桌面)和“Restock Beverage”(补充饮料)任务表现尤为突出。 此外智元机器人还单独验证了 ViLLA 架构中 Latent Planner 的作用,可以看到增加 Latent Planner 可以提升 12% 的成功率(66%->78%)。
GO-1 大模型借助人类和多种机器人数据,可泛化应用到各类的环境和物品中,快速适应新任务、学习新技能。同时,它还支持部署到不同的机器人本体完成落地,并在实际的使用中持续不断地快速进化。 这一系列的特点可以归纳为 4 个方面:
智元机器人还预告了下一代具身智能机器人产品,不过没有透露推出时间。
论文链接: https://agibot-world.com/blog/agibot_go1.pdf |

© 2013-2016 Discuz Team. Powered by Discuz! X3.5