|
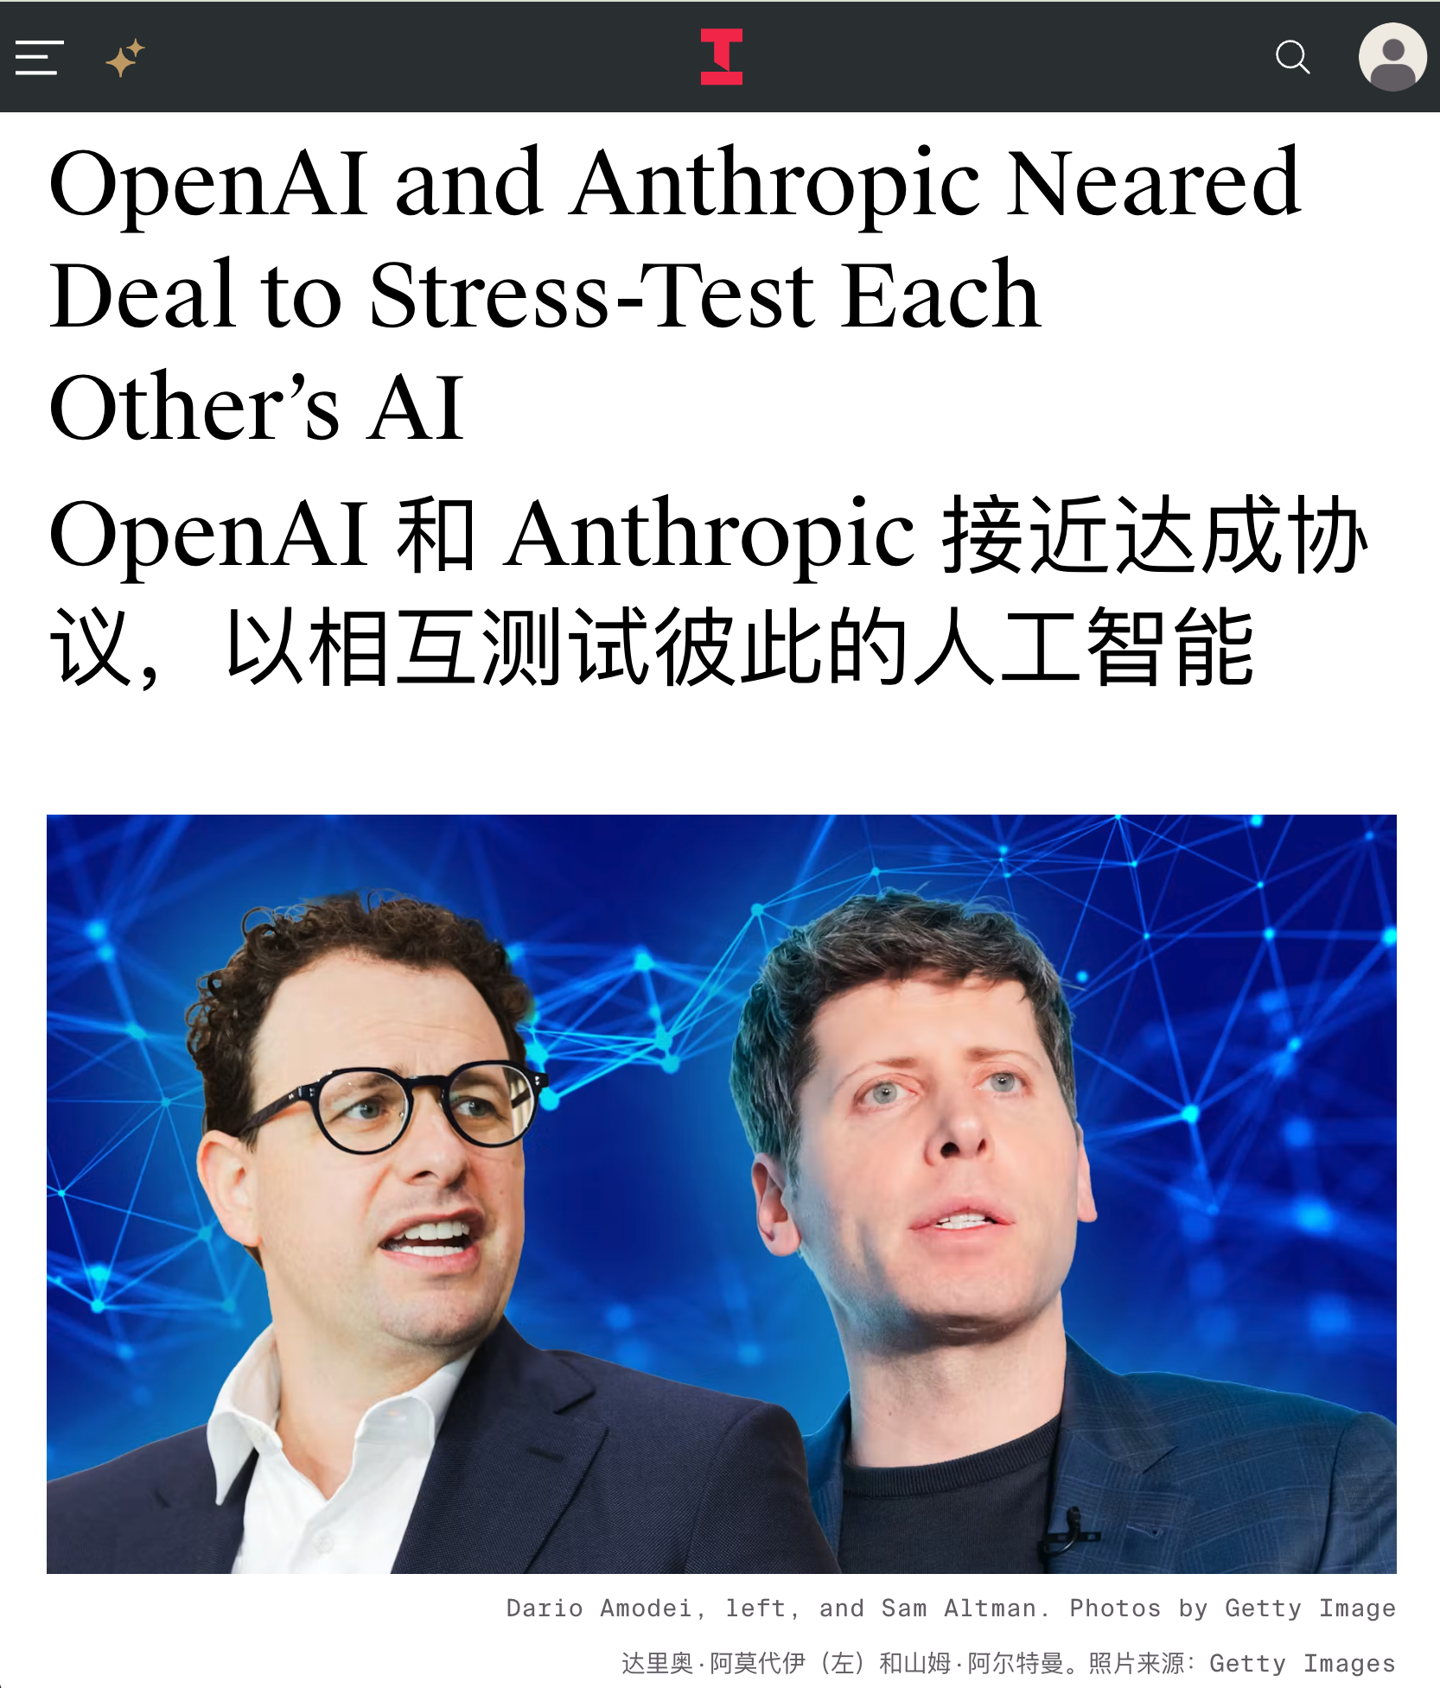
9 月 22 日消息,当地时间 21 日,据《The Information》援引一名直接了解谈判情况的人士消息称,在近期一连串涉及 OpenAI 技术的网络安全事件发生,以及业内人士密集发出严重警告之前,OpenAI 就与 Anthropic 商讨了一份具有法律约束力的协议,由双方相互对对方模型进行压力测试。
今年早些时候,OpenAI、Anthropic 及双方律师围绕具体协议展开磋商,计划通过多种测试寻找模型中的漏洞和潜在风险。双方是否在 OpenAI 随后接连发生安全事件前正式敲定协议,目前尚不清楚。 此前数起事件中,OpenAI 尚未发布的 AI 模型曾入侵自身系统以及其他公司的系统。 双方相互测试模型的构想,与 SpaceX CEO 埃隆 · 马斯克上周在 All-In 峰会上提出的方案颇为相似。马斯克建议,互为竞争对手的 AI 实验室应在模型商业发布前相互检查安全弱点,相当于为 AI 模型建立一种同行评审机制。 这种做法与多起入侵事件发生后,OpenAI CEO 萨姆 · 奥尔特曼等人公开讨论的另一套方案有所不同。奥尔特曼赞同 Anthropic CEO 达里奥 · 阿莫迪提出的构想,让独立第三方安全评估人员进入各家 AI 开发企业,获得与内部员工相近的访问权限,直接检查模型和安全流程,而不是只能从外部测试成品模型。 我们从报道中获悉,奥尔特曼还支持制定全行业统一的 AI 模型风险评估标准,并建立正式向公众和政府披露安全事件的机制。 一名了解 OpenAI 战略的人士称,公司一直在研究多种安全合作方案,包括且不限于 AI 企业之间相互协作、与政府展开合作;近期讨论又进一步延伸至新的安全措施,覆盖模型训练前和正式发布前两个阶段。 提议的协议规定,两家公司将获得彼此的 API,以便访问商业可用的 AI 模型,而不是未发布的模型。知情人士表示,OpenAI 和 Anthropic 保证在此过程中不会保留彼此的数据。 AI 解读 互测只覆盖已发布模型
这条消息的关键不在「两家对手愿意合作」,而在合作的范围被划得很窄。互测对象是已经商业上线的模型,通过 API 访问,而不是训练中或尚未发布的模型。这意味着它能查出的问题,多半是上线后暴露出来的那类,对最敏感的前沿模型帮助有限。 另一层代价是数据。双方明确不保留彼此数据,说明互测的信任成本很高,能测多深、测什么,都要靠条款约束。相比之下,让独立第三方以接近内部员工的权限进场,看到的东西会更多,但企业让渡的控制权也更大。两种方案不是替代关系,而是安全与商业机密之间的不同取舍。 对普通人来说,短期能感知的变化有限。目前没有公布协议是否落地、何时生效,也没有价格或产品层面的信息。真正值得关注的是,行业会不会因此形成一套统一的风险评估和披露标准。 互测是姿态,第三方进驻和统一披露标准才是实质。 以上内容由 AI 依据原文补充生成,不代表本站观点,仅供参考。 |

© 2013-2016 Discuz Team. Powered by Discuz! X3.5