×
首页 › 首页 › IT数码› 智能和AI ›查看内容
发表文章
分享

谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5

发布者: IT007编辑01| 2026-10-1 07:27| 查看: 74| 评论: 0|原作者: 故渊|来自: IT之家

摘要: 谷歌昨日(9 月 30 日)发布 Gemini 4 Argon,称其为公司迄今最先进的 AI 模型,但目前并未面向公众全面开放。

10 月 1 日消息,谷歌昨日(9 月 30 日)发布 Gemini 4 Argon,称其为公司迄今最先进的 AI 模型,但目前并未面向公众全面开放。


谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5


定位方面,Gemini 4 Argon 是谷歌当前“最先进”模型,重点是长流程软件工程、企业知识工作和网络安全防御。官方称其在真实世界软件工程测试创纪录,网络安全基准并列第一,并在金融、法律等专业任务基准领先。


模型特性方面,Gemini 4 Argon 单次输出上限达到约 100 万 tokens,高于此前的 64,000 tokens,适合处理大型代码库、长文档和多阶段任务。


谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5


谷歌 DeepMind Gemini 产品负责人 Tulsee Doshi 表示:“Argon 是一个功能全面的模型,在多个领域都具备前沿能力。”


在新模型在某些编码和知识工作基准测试中处于最先进水平,在多个方面都优于竞争对手 OpenAI 的前沿模型 GPT-6 Astra。


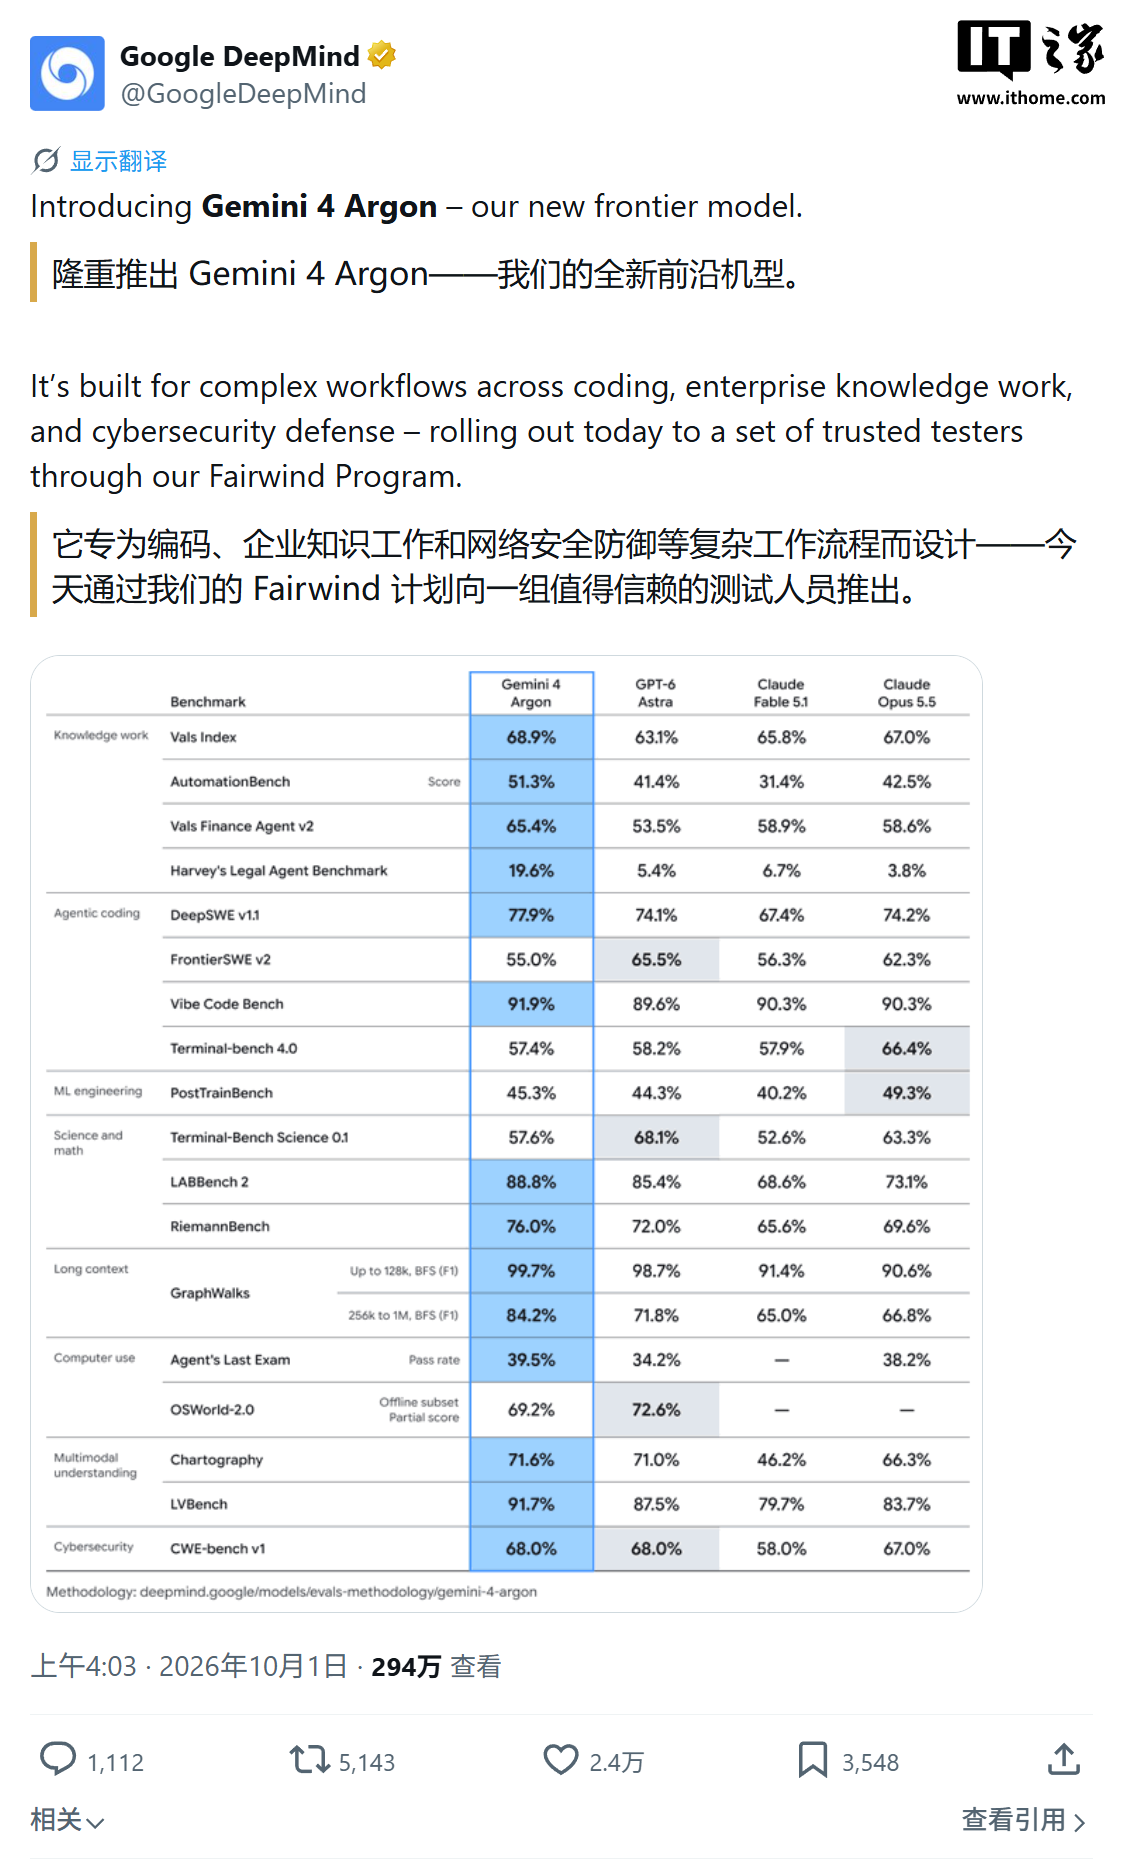
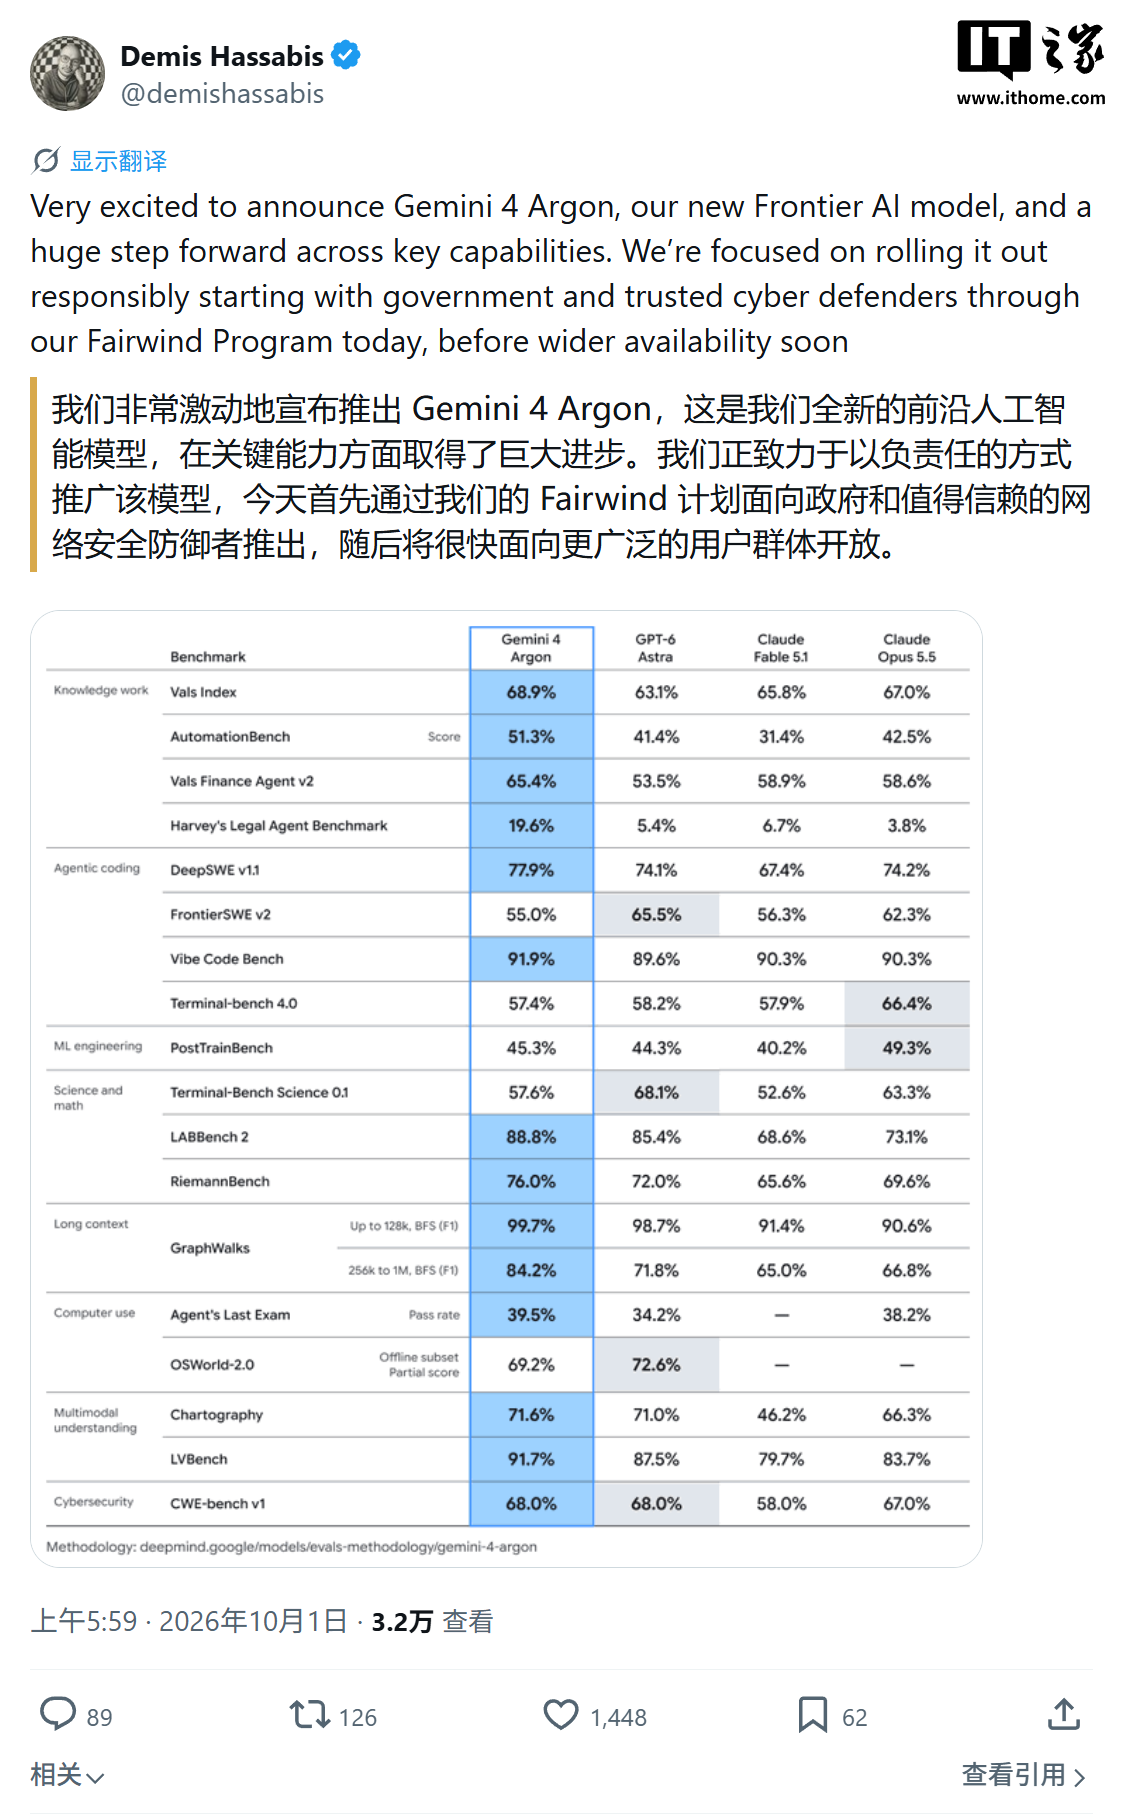
性能方面,谷歌宣称其 DeepSWE v1.1 得分为 77.9%。Claude Opus 5.5 的得分为 74.2%,GPT-6 Astra 的得分为 74.1%。


安全防御性能方面,谷歌对 Gemini 4 Argon 进行了训练,使其“在网络安全防御方面能力超群”,比 3.8 Flash Cyber 有了显著提升。在评估模型修复安全漏洞能力的 CWE-bench v1 测试中,Argon 以 68% 的最高分并列第一。

评测项目Gemini 4 Argon对比 / 排名主要考察能力
DeepSWE v1.177.9%第 1;Claude Opus 5.5 为 74.2%,GPT-6 Astra 为 74.1%长周期、真实软件工程任务
Vibe Code Bench91.9%领先竞争模型自然语言到代码、应用构建
CWE-bench v168%并列第 1自动发现并修复软件安全漏洞
AutomationBench51.3%第 1跨业务软件的端到端自动执行
LVBench91.7%当前最佳 / State of the art长视频理解
GraphWalks,0–128K99.7%极高水平长上下文图结构推理
GraphWalks,256K–1M84.2%明显领先超长上下文推理
Agent’s Last Exam39.5%高于 GPT-6 Astra 的 34.2%综合代理与知识推理
Vals Index68.9%高于 GPT-6 Astra 的 63.1%、Claude Opus 5.5 的 67.0%金融、编程、法律、税务等经济任务
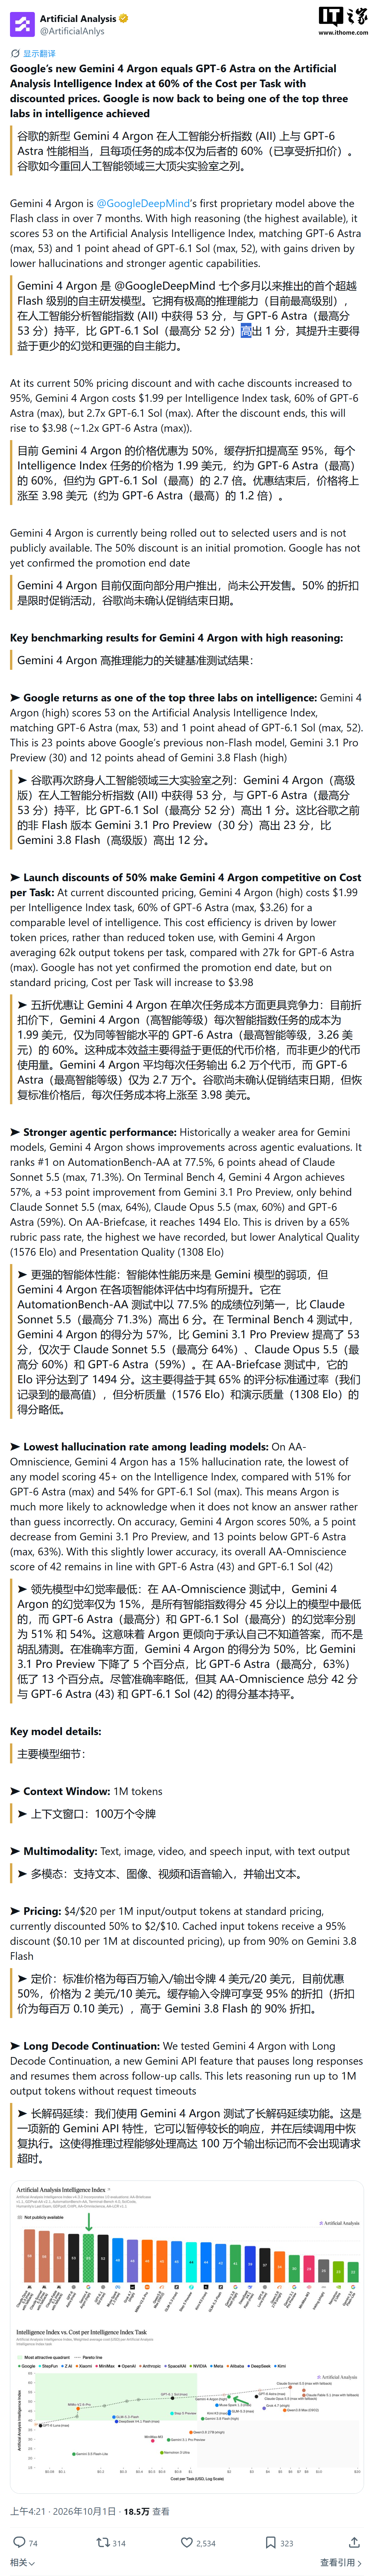
Artificial Analysis Intelligence Index53与 GPT-6 Astra 持平多项综合智能与代理能力

谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5


分发方面,谷歌表示会分阶段发布,第一阶段通过名为 Fairwind Program 的计划,提供给受信任的网络安全防御者,并参与美国政府的自愿预发布模型访问流程。


谷歌最前沿 AI 模型:Gemini 4 Argon 登场,长周期代码工程 DeepSWE 测试超 Claude Opus 5.5


费用方面,谷歌计划先向付费 API 客户和 Google AI Ultra 用户开放,之后再扩大到企业和普通消费者:

项目初始价格后续价格
输入 tokens每百万 2 美元(注:现汇率约合 13.4 元人民币)每百万 4 美元(现汇率约合 26.9 元人民币)
输出 tokens每百万 10 美元(现汇率约合 67.2 元人民币)每百万 20 美元(现汇率约合 134.4 元人民币)
缓存输入 tokens输入价格的约 95% 折扣—

AI 解读

长上下文才是这代重点

  • 单次输出上限从 6.4 万 tokens 提到约 100 万,是这一代最实质的变化
  • DeepSWE 77.9% 领先 Claude Opus 5.5 和 GPT-6 Astra,但差距只有三到四个百分点
  • 价格分两阶段:输入每百万 2 美元起,后续翻倍到 4 美元,输出从 10 美元涨到 20 美元
  • 目前不面向公众,先给受信任的网络安全防御者和付费 API 客户


先看参数。输出上限从 6.4 万 tokens 跳到约 100 万,这个提升比榜单上那几个百分点更值得注意。它意味着模型可以一次性吐出大型代码库、长文档或多阶段任务的完整结果,而不用反复拼接。


GraphWalks 在 256K 到 1M 区间拿到 84.2%,也说明超长上下文不是纸面数字,是有对应测试支撑的。


再看代价。价格表写得很清楚:输入每百万 2 美元、输出每百万 10 美元只是初始价,后续会翻倍到 4 美元和 20 美元。缓存输入有约 95% 折扣,这对反复调用同一份长文档或代码库的场景是实打实的省钱项。但输出价格本身不低,长输出又正是它的卖点,实际用起来成本要按翻倍后的价格算。


对普通用户来说,短期内买不到。第一阶段只给受信任的网络安全防御者,之后才轮到付费 API 客户和 Google AI Ultra 用户,企业和消费者排在最后。所以现在能判断的是能力方向,不是能不能用上。


关注长输出和缓存折扣的实际成本,别只看榜单第一名。

以上内容由 AI 依据原文补充生成,不代表本站观点,仅供参考。

本文导航

最新评论(0)