
|
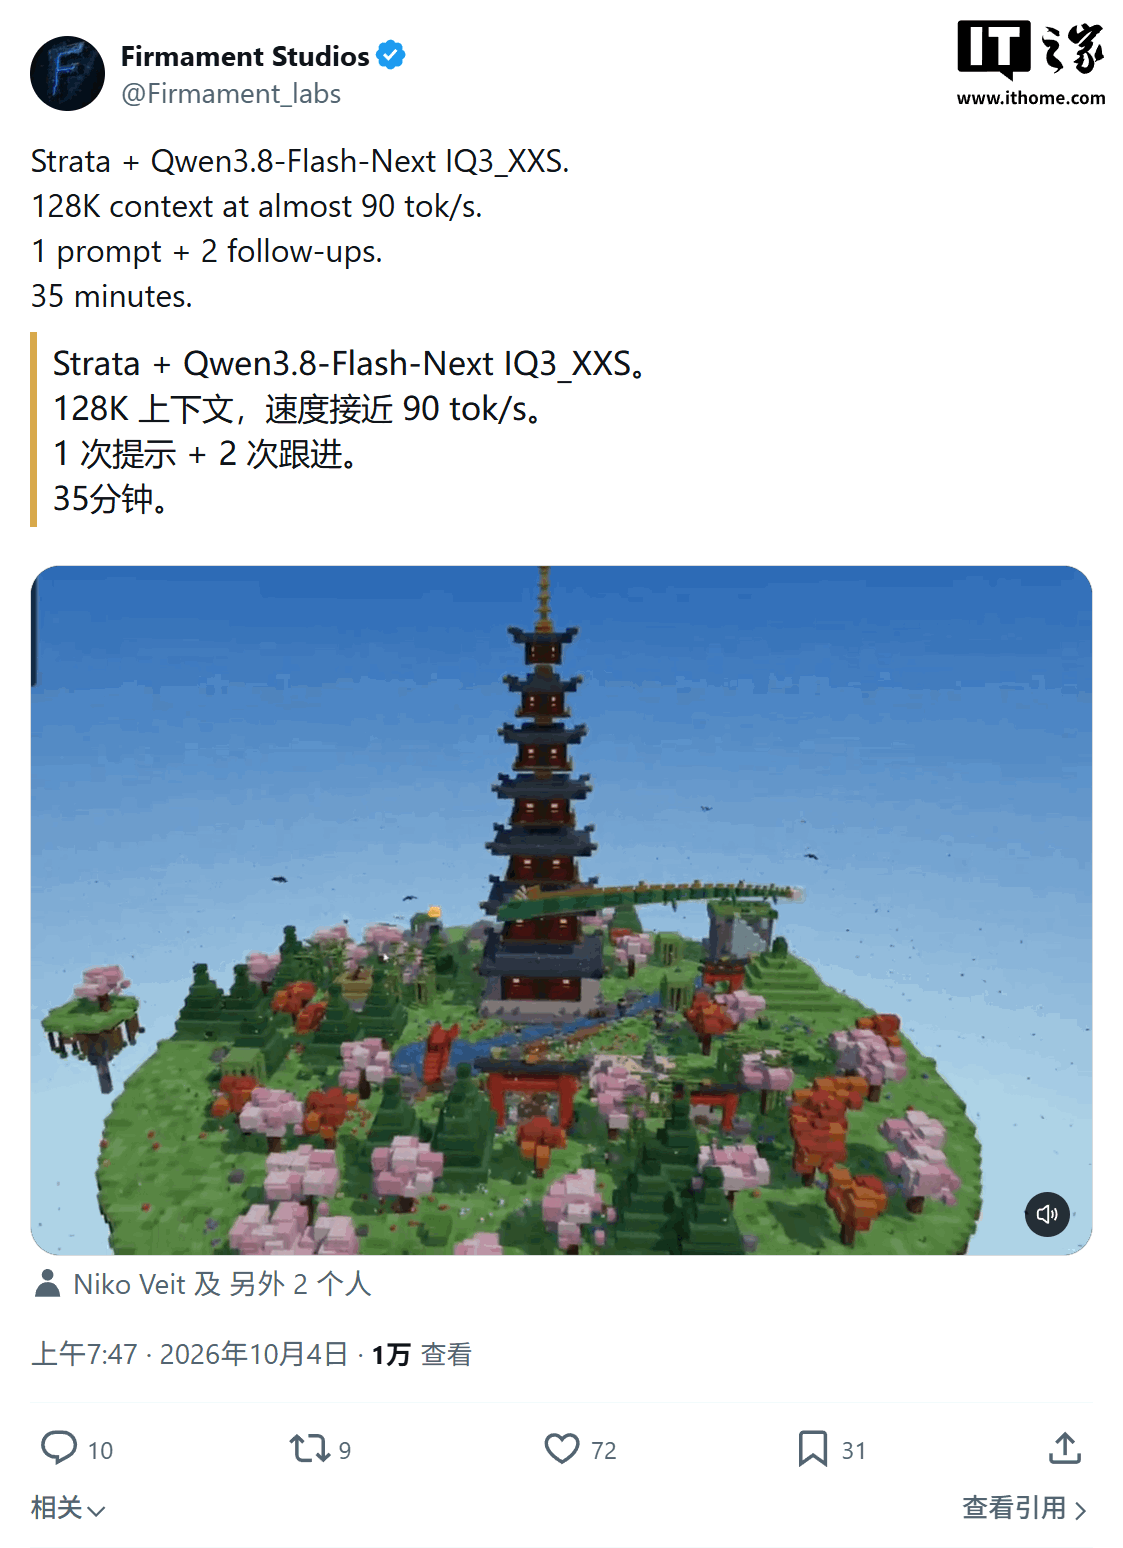
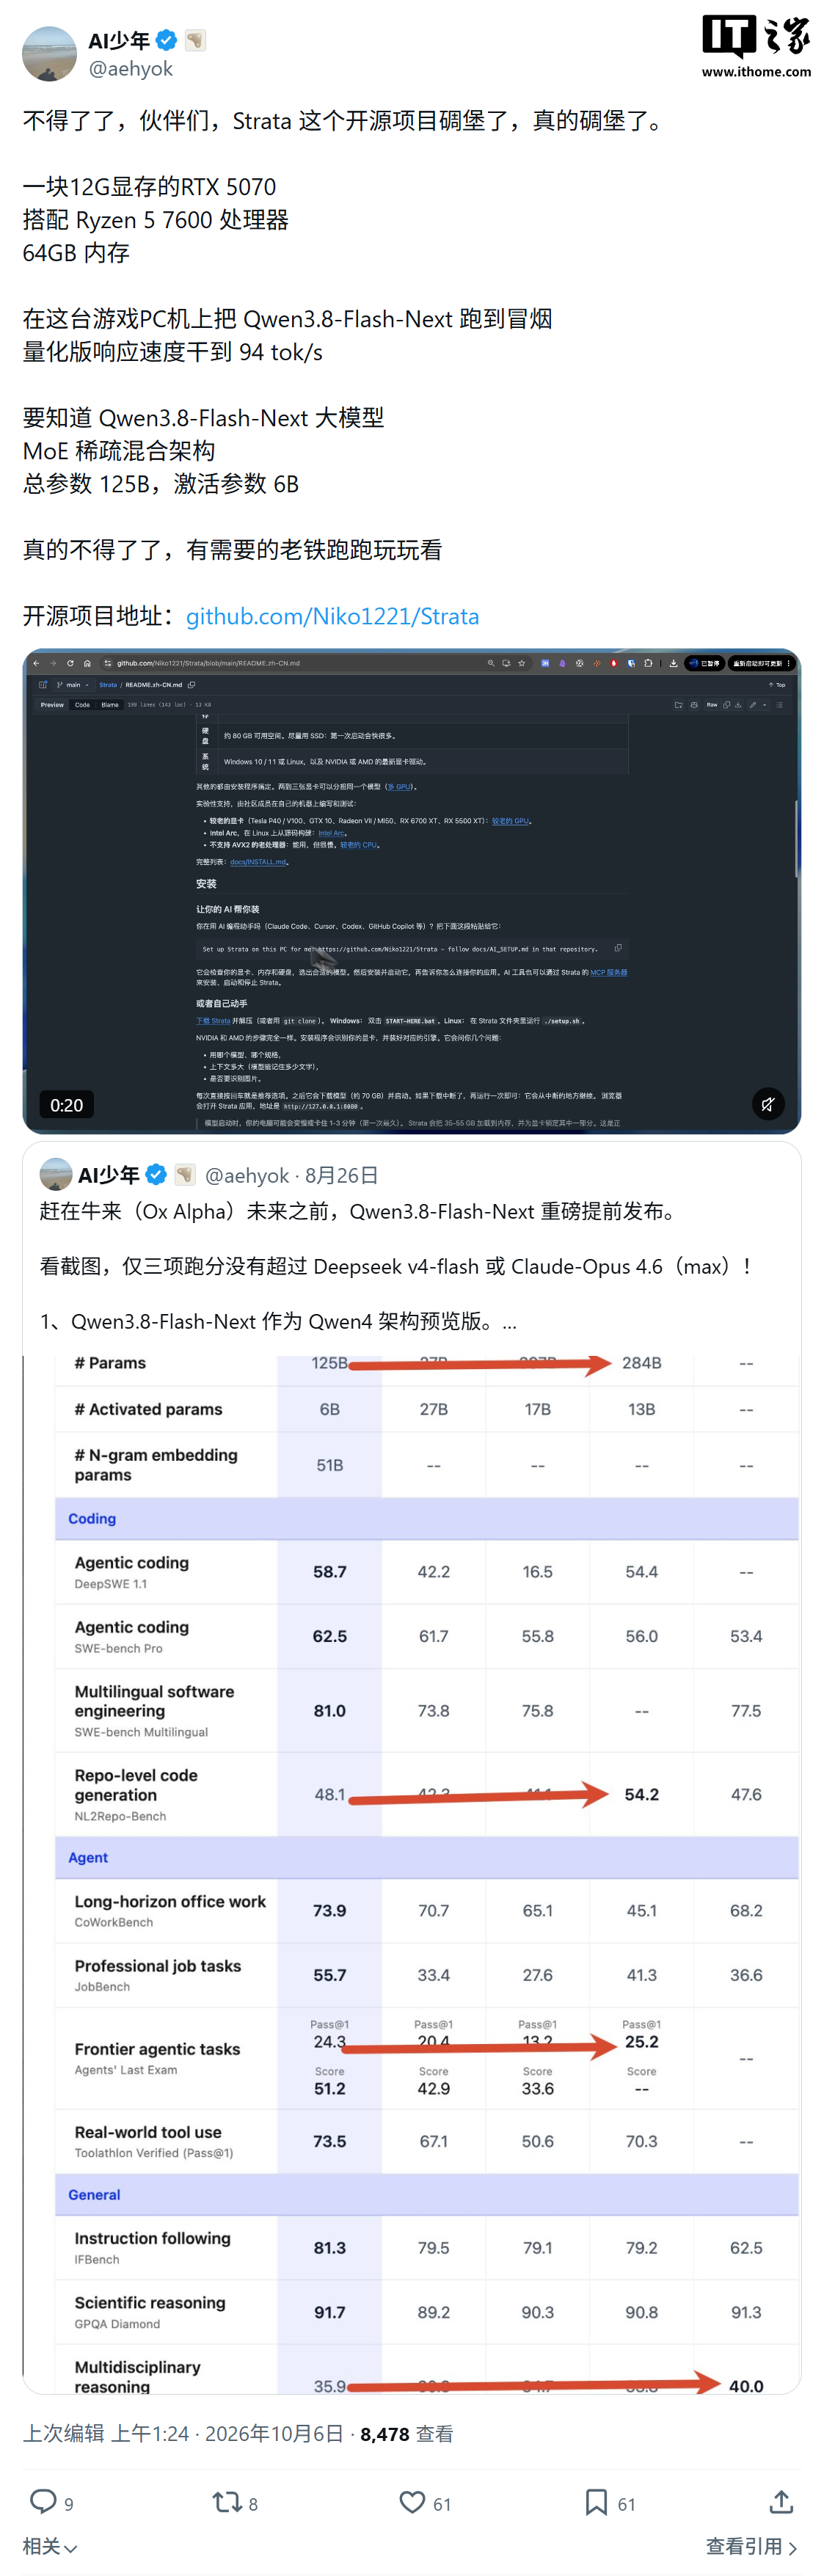
10 月 6 日消息,科技媒体 gigazine 今天(10 月 6 日)报道,报道称开发者 Niko1221 开源推出 Strata 引擎,可以在 12GB 及以上显存的消费级显卡上,运行量化的 Qwen3.8-Flash-Next 模型(1250 亿参数)。
注:Qwen3.8-Flash-Next 模型是阿里巴巴 Qwen 团队于 2026 年 8 月推出的多模态混合专家(MoE)模型的压缩版本,配有 125B 参数,另含 51B 参数的 n-gram 嵌入表,原生支持 262K token 上下文长度。
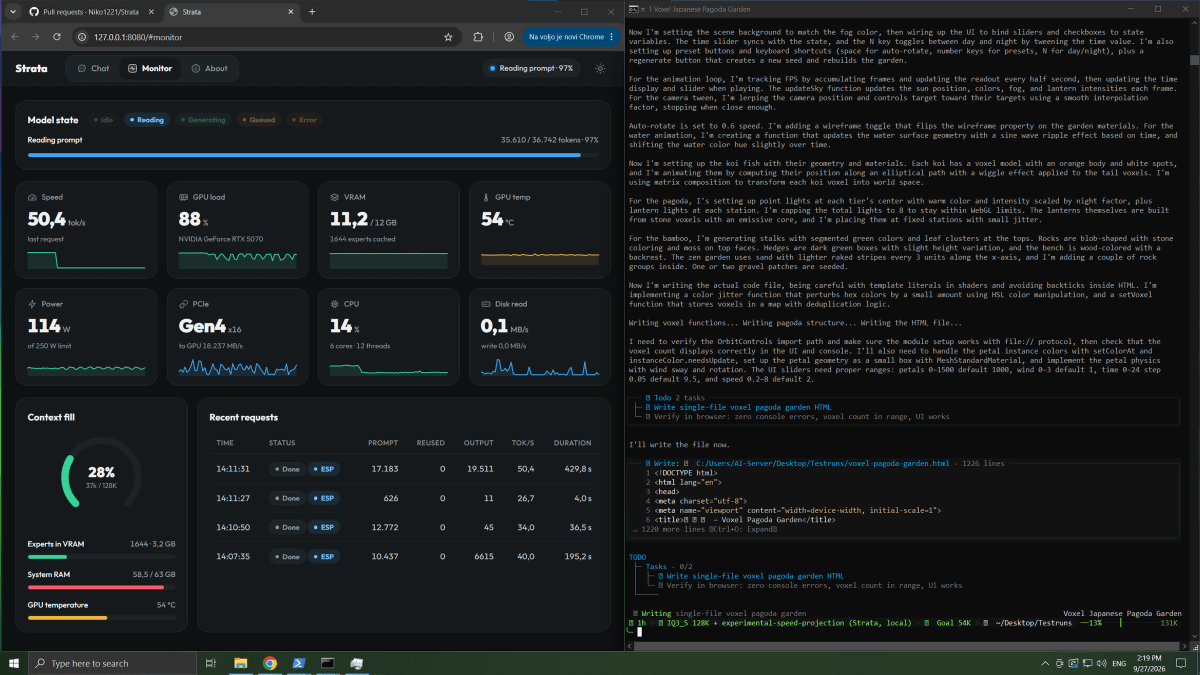
Strata 为了降低显存占用,主要采用两项关键技术:其一是将 MoE(混合专家)模型整体载入 RAM,仅将高频使用的专家模型载入 VRAM。其二使用轻量模型进行投机解码,预测下一 Token 以加速推理过程。 硬件要求方面,运行 Qwen3.8-Flash-Next 需满足最低配置:12GB 以上 VRAM 的 NVIDIA 或 AMD 显卡、32GB 以上 RAM、80GB 以上存储空间(推荐 SSD)、Windows 10/11 或 Linux 系统。 性能方面,在 NVIDIA GeForce RTX 5070(12GB VRAM)、Ryzen 5 7600、64GB RAM 配置下,2 比特量化版 Q2_0 达到 94 词元 / 秒推理速度,3 比特量化版 IQ3_S 为 53 词元 / 秒。AMD Radeon RX 9070 XT(16GB VRAM)环境下,Q2_0 版本达到 60 词元 / 秒。
英伟达主机性能表现: 硬件配置: NVIDIA RTX 5070(12 GB 显存),AMD Ryzen 5 7600,64 GB 系统内存。
AMD 主机性能表现: 硬件配置:AMD RX 9070 XT(16 GB 显存),AMD Ryzen 9 3900X,47 GB 内存。
这里的“写答案”对应生成回复(输出)的速度,“阅读提示”对应处理你输入的 prompt(上下文)的速度。 参考 AI 解读 GB 显存跑 125B 模型的代价
这套方案真正的重点不是速度,而是把 1250 亿参数的模型塞进 12GB 显存这件事本身。做法是把 MoE 的专家权重留在系统内存里,只把当前用得最多的专家搬进显存,再用一个小模型做投机解码来补速度。代价也很直接:内存和显存之间要频繁搬运数据,所以对内存容量和带宽的要求不低,32GB 只是起步。 速度数字要分开看。94 词元每秒是 2 比特量化下的结果,量化越激进,模型精度损失越大,3 比特版本速度就掉到 53。也就是说,快和准在这里是互相拉扯的,选哪个版本取决于你更在意响应速度还是回答质量。 对普通用户来说,这套方案的意义是本地跑大模型的门槛从专业卡下放到了消费级显卡,但前提是你得有一块 12GB 以上显存的卡、至少 32GB 内存和足够的硬盘空间。目前还没有公布具体的发布时间和价格信息。 想本地跑大模型,先看内存和显存够不够,再决定用哪个量化版本。 以上内容由 AI 依据原文补充生成,不代表本站观点,仅供参考。 |



 扫码下载 IT007 App