|
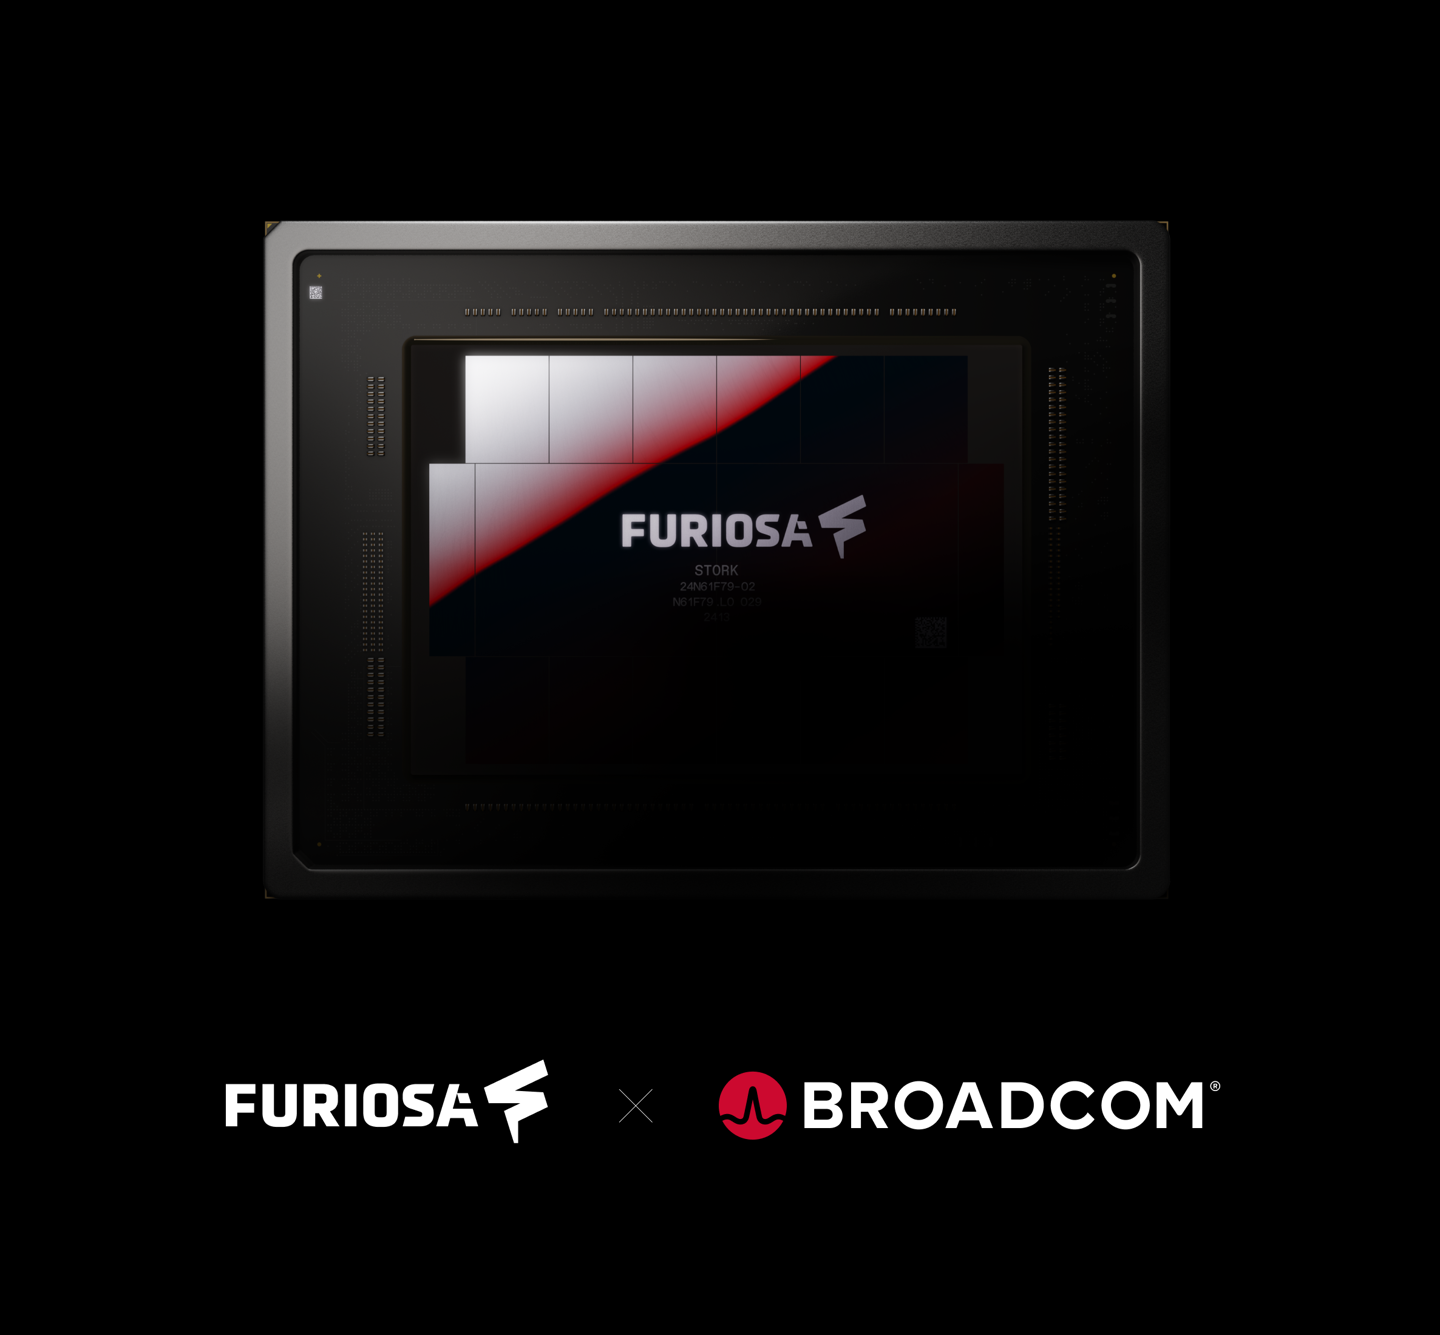
9 月 22 日消息,据韩媒 ZDNET Korea 当地时间 21 日报道,韩媒 AI 半导体初创企业 FuriosaAI 昨日公布了其第三代 AI 推理加速器的技术细节。
该加速器由 FuriosaAI 与 Broadcom(博通)合作开发,拥有 2 颗“光罩极限级”2nm 计算裸晶、1 颗独立 I/O 裸晶、12 个 48GB HBM4 (E) 内存堆栈,机架内采用 SUE 全连接拓扑,还支持 PCIe Gen7。 FuriosaAI 表示,该芯片的物理尺寸大约是第二代芯片 (RGND) 的 8 倍;算力可达 32 PFLOPS,是 RGND 的 32 倍;HBM 内存容量达 576GB,是 RGND 的 12 倍;HBM 内存带宽达 48TB/s,是 RGND 的 32 倍。 AI 解读 推理芯片的算力与代价
这一代最值得注意的不是32倍这个数字,而是它把算力、带宽、容量按不同倍数拉开。算力和带宽同步涨32倍,说明设计目标是不让内存拖累计算;容量只涨12倍,则意味着单卡仍装不下超大模型,多卡互联和机架级拓扑才是实际部署的关键。 尺寸涨到8倍、用上2nm和HBM4,代价是功耗、散热和成本大概率同步上升。这类芯片面向的是数据中心,不是普通用户的桌面设备。对普通人来说,它影响的是云端推理服务的速度和单价,而不是能买到的硬件。 目前还没有公布价格、功耗和上市时间,32倍算力能否转化为实际吞吐,还要看软件栈和互联效率。 参数亮眼,但功耗、价格、上市时间都未公布,先看落地。 以上内容由 AI 依据原文补充生成,不代表本站观点,仅供参考。 |

© 2013-2016 Discuz Team. Powered by Discuz! X3.5