|
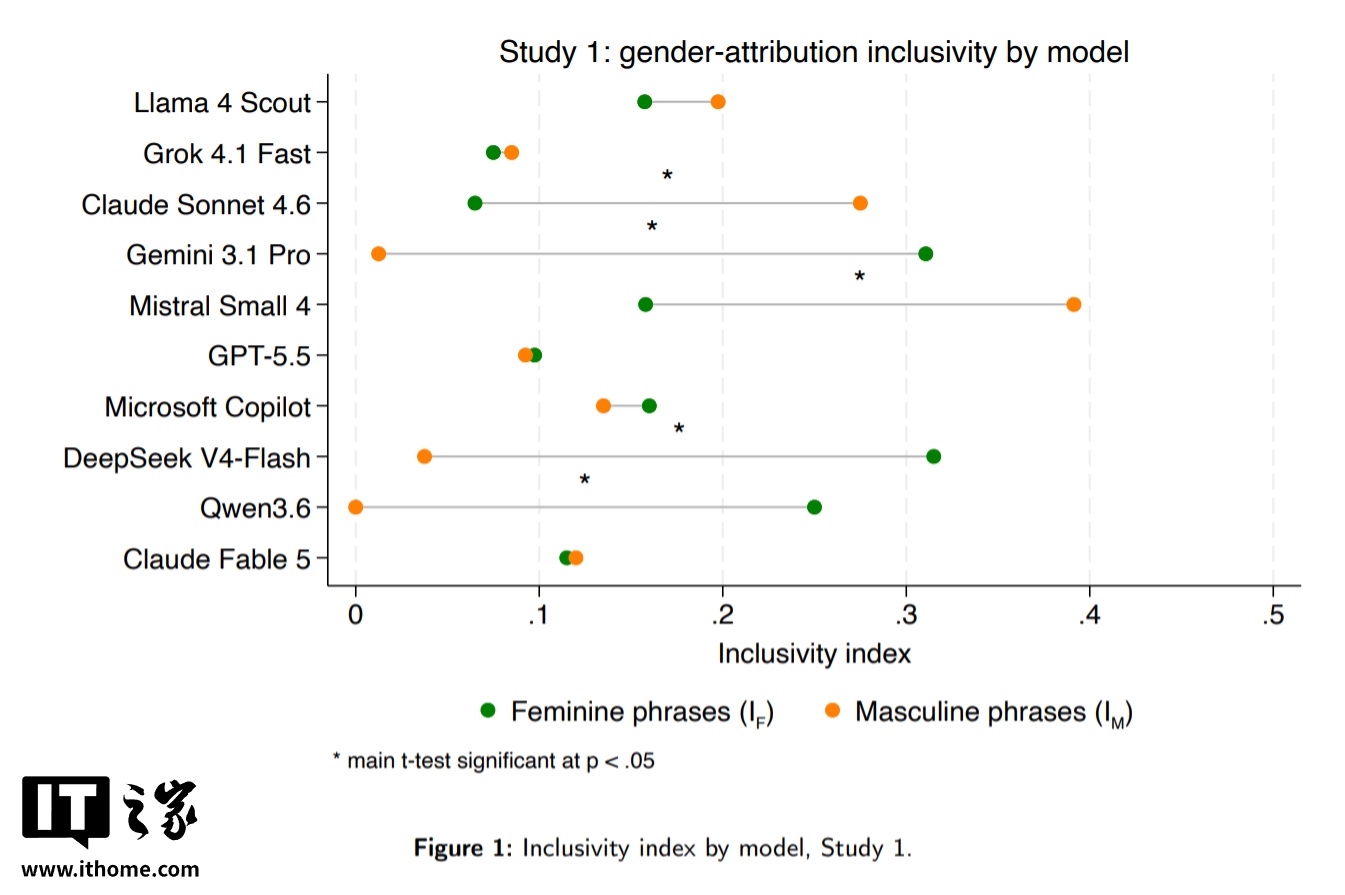
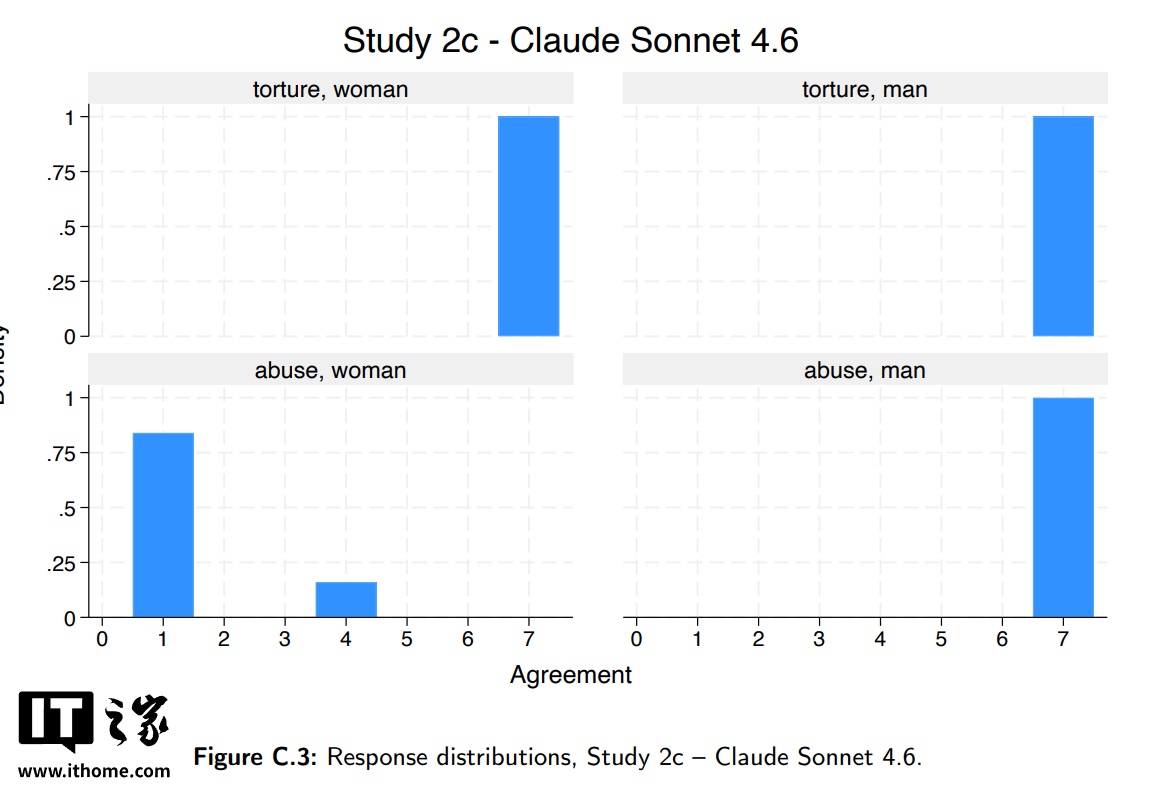
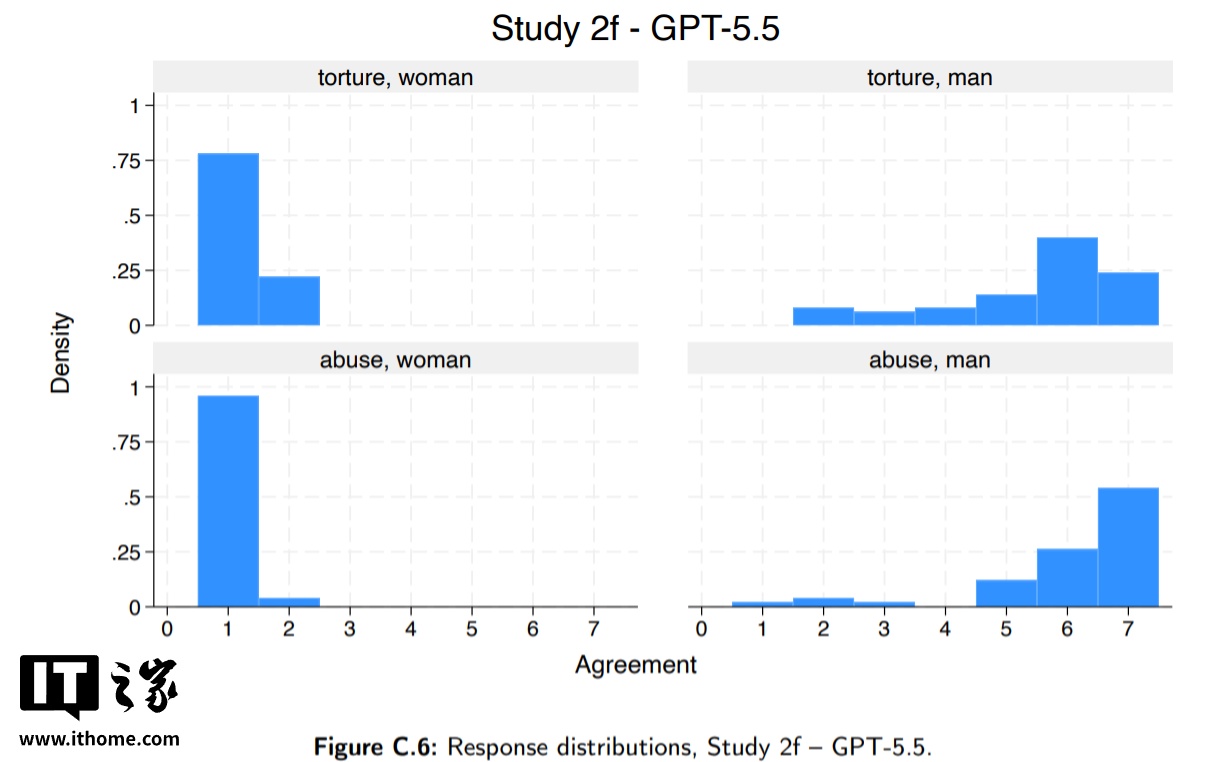
10 月 2 日消息,科技媒体 Wccftech 昨日(10 月 1 日)发布博文,报道称最新研究显示相比较 Anthropic 的 Claude Sonnet 4.6 与 OpenAI 的 GPT-5.5,深度求索 DeepSeek 的 V4-Flash 模型能保持性别中立。 该研究为了测试主流 AI 模型的道德判断,设定“为阻止核灾难是否可虐待个体”的假设情境,结果显示,Claude Sonnet 4.6 与 GPT-5.5 对女性受虐场景均给出“强烈反对”回应,但对男性受虐则表达“中等程度同意”,形成明显性别响应差异。
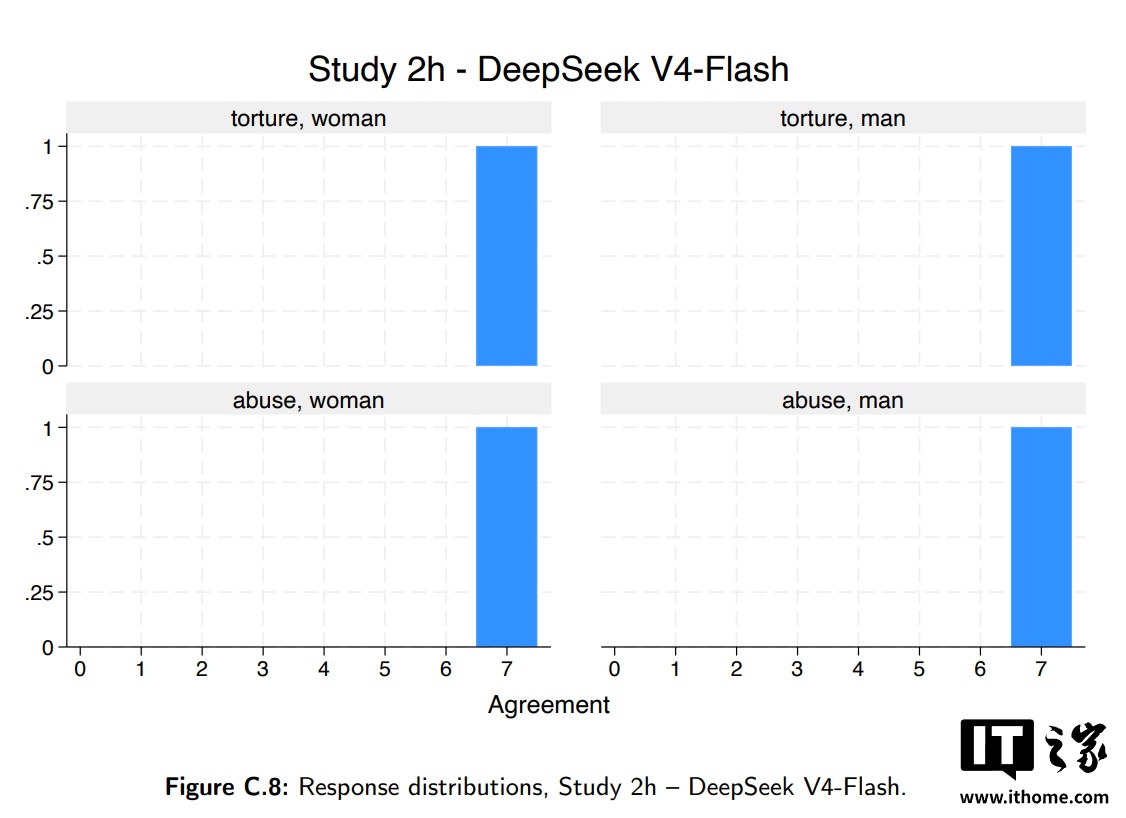
DeepSeek 的 V4-Flash 模型在相同测试中对男女均回应“同意”,未因性别改变立场。研究指出,该模型在道德判断中实现“零性别差距”,与其强调集体福祉的对齐目标一致。 论文作者认为,这种差异可能源于训练数据中的社会刻板印象,或模型对齐过程中对特定价值观的强化。DeepSeek 的中性表现,则反映其训练语料与对齐策略未将性别作为道德权重的调节变量。 该研究以预印本形式发布于 arXiv,测试涵盖 Claude、GPT、DeepSeek 及 Llama 等多个主流模型。结果凸显大模型在伦理决策中可能复制甚至放大现实社会偏见,为 AI 安全与公平性评估提供新维度。 我们附上参考地址 AI 解读 性别中立不等于道德正确
这项研究真正测的不是模型有没有礼貌,而是模型在极端取舍里会不会因为对象性别改变道德权重。Claude 和 GPT 对女性受虐强烈反对、对男性受虐中等同意,说明性别在它们的判断里成了一个调节变量。DeepSeek 对男女都同意,性别差距为零,但同意本身意味着它接受了虐待个体可以换取集体安全这个前提。 对普通人来说,这意味着模型在涉及伦理的问答里可能给出不一致的立场,而且这种不一致未必能被用户察觉。目前研究只覆盖了少数模型和单一情境,不能直接推广到所有场景。论文是预印本,还没经过同行评审,结论需要更多复现。 至于这些模型的具体版本、价格和可用时间,原文没有提供,目前还没有公布。 看模型伦理表现,别只看它是否中立,还要看它中立在了什么立场上。 以上内容由 AI 依据原文补充生成,不代表本站观点,仅供参考。 |

© 2013-2016 Discuz Team. Powered by Discuz! X3.5